Cuando aparecieron los resultados de State of Devs 2026, quise mirar más allá de los gráficos de la web.
Así que hice lo perfectamente razonable para un developer: construir un scraper en Node.js y TypeScript, descargar los datos y empezar a curiosear. 5463 participantes, unos cuantos JSON grandes y una cantidad totalmente sensata de curiosidad después, empezaron a aparecer algunos patrones.
Esta es mi interpretación del conjunto de datos. La participación fue voluntaria, las correlaciones no demuestran causas y algunas muestras por país son suficientemente pequeñas como para levantar una ceja. Conviene tenerlo presente. Aun así, hay bastante que explorar.
El código generado con IA ya es algo normal
El dato llamativo no es cuántos developers han probado la IA. Es cuánto código dicen producir con ella.
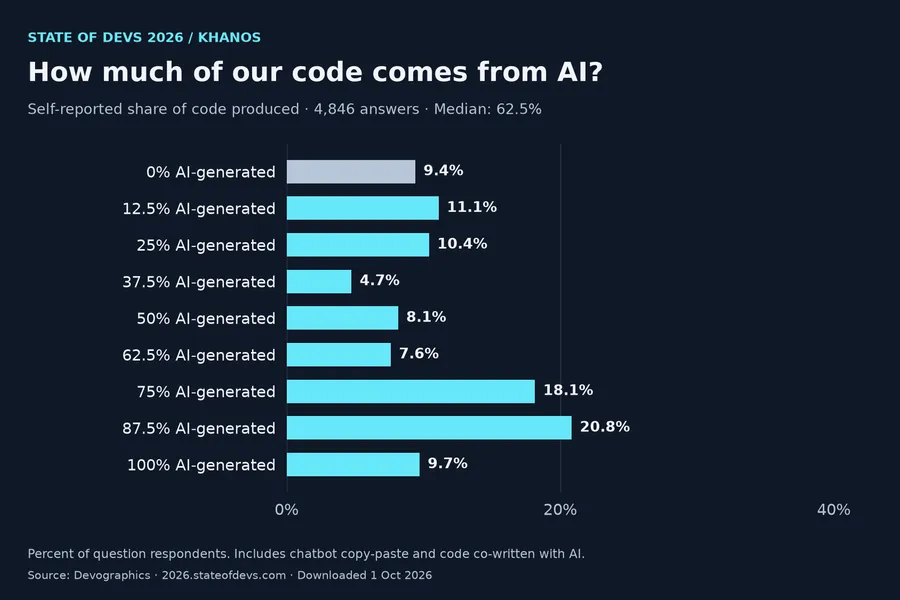
La proporción media declarada es 56,1%, con una mediana de 62,5%. Aproximadamente 48,7% indicó que al menos tres cuartas partes de su código se genera con IA.
Cuánto código dicen generar con IA
4846 respuestas- 0% generado con IA9,4%
- 12,5% generado con IA11,1%
- 25% generado con IA10,4%
- 37,5% generado con IA4,7%
- 50% generado con IA8,1%
- 62,5% generado con IA7,6%
- 75% generado con IA18,1%
- 87,5% generado con IA20,8%
- 100% generado con IA9,7%
Estimaciones personales. Incluye código copiado de chatbots y escrito con herramientas de IA. Datos
La pregunta incluye código copiado de chatbots y escrito con herramientas de IA. Son estimaciones personales, no una auditoría del historial de Git. Pero, dentro de esta muestra, programar con ayuda de IA es claramente un flujo habitual.
Eso hace que “uso IA” sea una diferencia menos interesante. Si todo el mundo puede acceder a modelos parecidos, ¿de dónde sale la ventaja al desarrollar software?
Una respuesta plausible está alrededor del modelo: flujos con agentes, contexto útil, herramientas conectadas mediante MCP y pruebas que realmente detectan comportamientos rotos. También cosas menos vistosas: entender la arquitectura, leer diffs, seguir la pista a un bug y reconocer cuándo una respuesta segura está equivocada.
Un modelo con el contexto adecuado del repositorio y una forma de ejecutar comprobaciones tiene un trabajo distinto al de un chatbot adivinando cómo funciona el backend. Coordinarlo es un problema de ingeniería por sí mismo.
Pedirle algo al modelo empieza a ser la parte fácil. Saber si su respuesta merece llegar a producción es la habilidad difícil. Es una interpretación, no algo que pueda demostrar un porcentaje de código generado. La encuesta no mide la productividad ni la calidad de esos flujos.
Mucho frontend. La IA/LLM sigue siendo un rincón más pequeño.
Usar IA para programar y trabajar en sistemas de IA son cosas diferentes. Los datos sobre áreas de trabajo lo muestran bastante bien.
El 83,5% de quienes respondieron esa pregunta seleccionó frontend JavaScript. El 14,5% seleccionó trabajo con IA/LLM. Se podían elegir varias áreas, así que no son equipos rivales.
Mucho frontend; un grupo menor trabaja con IA/LLM
4868 respuestas- Frontend JavaScript83,5%
- Mediana de ingresos
- 90.000 US$
- Mediana de experiencia
- 12 años
- Registros ingresos / experiencia
- 3973 / 4004
- AI / LLM14,5%
- Mediana de ingresos
- 125.000 US$
- Mediana de experiencia
- 15 años
- Registros ingresos / experiencia
- 691 / 694
Áreas de trabajo con selecciones múltiples. Ingresos brutos anuales en USD, estimados a partir de tramos. Los grupos se solapan. Datos
La diferencia de ingresos tienta: la mediana publicada ronda 90.000 US$ para frontend y 125.000 US$ para IA/LLM. Pero mira la experiencia al lado: 12 años frente a 15.
Eso ya invita a frenar antes de anunciar un “bonus salarial por trabajar con IA”. También varían el país, el nivel del puesto, la forma de contratación y la especialización. Los cruces de ingresos y experiencia usan subconjuntos diferentes, y las estadísticas salariales se estiman a partir de tramos de ingresos brutos anuales en dólares estadounidenses.
El patrón más interesante es que este grupo menor de IA/LLM incluye a muchos ingenieros con experiencia. El trabajo en tooling tiene una mediana de 15 años, también. Construir la maquinaria que usan otros developers parece convivir con bastante experiencia. Los datos no establecen que una cosa cause la otra.
El modelo puede adelantarse a tu comprensión
Los riesgos de IA sirven de contrapeso a tanto código generado.
Lo que preocupa a los developers sobre la IA
4849 respuestas- Desplazamiento laboral54,7%
- Contenido de IA de baja calidad47,4%
- Efectos cognitivos / menor aprendizaje45,2%
- Problemas de seguridad35,0%
Porcentaje de quienes respondieron esta pregunta. Varias selecciones permitidas; las categorías se solapan. Son preocupaciones, no tasas de incidentes. Datos
El desplazamiento laboral y el contenido de baja calidad encabezan estas cuatro preocupaciones, pero resulta especialmente interesante el 45,2% preocupado por los efectos cognitivos. Esa opción describe un uso excesivo que deja a las personas dependientes de la IA. Mide una inquietud, no una pérdida de habilidades demostrada.
Este es un posible modo de fallo: el modelo produce algo que funciona antes de que el developer entienda por qué funciona.
Puede ser cómodo. También puede ser un sitio bastante peligroso para detenerse. En un código que no conoces, un ejemplo que pasa puede ocultar la restricción importante. La autenticación tiene límites de permisos. Las bases de datos tienen transacciones. La infraestructura tiene estado. La concurrencia tiene un talento admirable para reservarse las sorpresas hasta producción.
Durante un incidente, “el modelo dijo que estaba bien” no es un gran plan de recuperación.
La IA puede acelerar tareas concretas sin hacer desaparecer esas restricciones. Una interpretación razonable es que entender a fondo el sistema gana valor cuando generar código se vuelve más fácil. La habilidad se desplaza hacia comprender el sistema, verificar el cambio, detectar cómo puede fallar y recuperarse cuando algo se rompe.
Es un argumento a favor de usar IA con suficiente contexto y verificación para que su salida resulte útil. Aceptar más código a ciegas es una ambición bastante más limitada.
¿Preocupa cambiar de empleo o de carrera?
No es la misma pregunta, y la encuesta plantea las dos.
El 42,4% consideró probable o muy probable tener que cambiar de empleo por motivos ajenos a su voluntad en cinco años. Para un cambio de carrera, la cifra equivalente fue 26,2%. Las preguntas recibieron 5310 y 5334 respuestas, respectivamente.
La formulación exacta es “cambiar de carrera”. No pregunta directamente si desaparecerá la programación, y ninguna de las dos preguntas identifica a la IA como causa.
Aun así, la distancia resulta interesante. Parece haber más inquietud por la inestabilidad laboral que por tener que abandonar una carrera. Una posible lectura es una reorganización de roles, expectativas y habilidades. Las respuestas no permiten saber qué ocurrirá en esos cinco años.
Herramientas potentes, developers cansados
Los resultados sobre el trabajo merecen una pausa. Primero aparecen experiencias declaradas a lo largo de una carrera; después, otra pregunta sobre cómo se ha sentido el trabajo recientemente.
Problemas experimentados durante la carrera
5352 respuestas- Mala gestión63,0%
- Burnout62,5%
- Problemas de conciliación58,2%
- Aburrimiento54,3%
- Inseguridad laboral48,2%
- Problemas relacionados con la salud mental47,7%
- Remuneración insuficiente45,8%
Porcentaje de quienes respondieron esta pregunta. Varias selecciones permitidas; las categorías se solapan. Datos
Y cómo se siente el trabajo últimamente
4484 respuestas- Menor motivación65,6%
- Mayor cinismo60,2%
- Agotamiento emocional56,9%
- Más procrastinación53,3%
Porcentaje de quienes respondieron esta pregunta. Varias selecciones permitidas; las categorías se solapan. Datos
La mala gestión y el burnout superan el 60%. Los problemas de conciliación, el aburrimiento, la inseguridad laboral, los problemas relacionados con la salud mental y la remuneración insuficiente tampoco son detalles menores.
Una pequeña trampa al leer los datos: el identificador interno del grupo de conciliación es excessive_overtime, pero la etiqueta pública dice “Work-life balance issues”. El gráfico sigue esa formulación en lugar de fingir que cada respuesta equivale a un registro de horas extra.
La pregunta sobre experiencias recientes tampoco es agradable de leer. La menor motivación alcanza 65,6%, el mayor cinismo 60,2% y el agotamiento emocional 56,9%. Son experiencias declaradas, no diagnósticos clínicos.
Hay una tensión interesante. La conversación sobre herramientas de programación promete enormes mejoras de productividad, mientras muchos developers describen un trabajo agotador y menos gratificante. Estos datos no demuestran que la IA causara burnout ni que esas promesas se hayan cumplido.
Lo que sí sugieren es que producir más no se traduce automáticamente en una mejor experiencia de trabajo. Generar más rápido puede convivir con mala gestión, colas de revisión crecientes y expectativas poco realistas. Un equipo puede producir más código y seguir teniendo un martes miserable.
El trabajo remoto no desapareció
Entre tanta incertidumbre, un hallazgo menos dramático: la flexibilidad remota sigue muy presente en esta muestra.
La flexibilidad remota sigue presente
4585 respuestas- Híbrido41,3%
- A elección del empleado30,2%
- Totalmente remoto23,5%
- Sin trabajo remoto5,0%
Las cuatro categorías principales suman el 100%. Los códigos de texto libre no se añaden como grupos separados. Datos
El modelo híbrido es el más frecuente, con 41,3%. La elección del empleado representa 30,2%, y las organizaciones exclusivamente remotas 23,5%. Solo 5,0% indicó que no había trabajo remoto.
El trabajo totalmente remoto no domina. Pero desplazarse obligatoriamente cada día tampoco es lo habitual aquí. Los códigos adicionales del texto libre se solapan con las categorías principales: sumarlos como porciones extra contaría respuestas dos veces sin hacer ruido. JSON: útil, a veces travieso.
Un pequeño desvío: los ingresos del subgrupo de España
El cruce salarial de España contiene 140 registros. Su media publicada ronda 70.500 US$, con estos cuartiles:
| Percentil 25 | Mediana | Percentil 75 |
|---|---|---|
| 45.000 US$ | 70.000 US$ | 90.000 US$ |
Son ingresos brutos anuales en USD, derivados de los tramos de la encuesta. El subgrupo es pequeño frente al total y la participación es voluntaria. Varían la experiencia y la especialización, y los ingresos de un contratista no son necesariamente comparables con la remuneración de un empleado. Es un dato público interesante, no una referencia de cuánto debería ganar nadie.
Lo interesante se mueve alrededor del código
Mi lectura es que estos datos aportan poco a una historia sencilla en la que desaparece la programación. Muestran un uso extendido de IA para programar, un grupo menor construyendo sistemas de IA y bastante incertidumbre laboral.
Cuando generar código se vuelve más fácil, escribir la implementación resulta menos distintivo. Entender sistemas, definir el problema, revisar cambios, diseñar arquitectura, depurar fallos, proteger el software y tomar buenas decisiones siguen exigiendo criterio.
Lo curioso de unos modelos mejores programando es que hacen más difícil ignorar la ingeniería que rodea al código. ¿Qué pasa cuando la realidad contradice al modelo? Alguien sigue necesitando entender el sistema lo suficiente para averiguarlo.
Este análisis apenas rasca la superficie. Construí el scraper porque quería unas cuantas respuestas más. Ahora tengo varios megabytes de JSON y bastantes más preguntas.
Bajo el capó: datos, denominadores y fuentes
El scraper comenzó en /page-data/en-US/page-data.json, siguió pageContext.next.path y previous.path y descargó las 11 páginas enlazadas de resultados en inglés el 1 de octubre de 2026. La encuesta estuvo abierta del 5 de julio al 5 de septiembre de 2026.
Los gráficos se calculan a partir de esa copia local, usando las respuestas de cada pregunta en lugar del total de participantes. Las medianas de ingresos y experiencia vienen de las estadísticas publicadas para cada cruce. Importan las respuestas ausentes y las categorías con selecciones múltiples. Los grupos menores de IA/LLM y por país merecen más cautela.
La muestra procede principalmente del público de Devographics y de redes sociales. Son observaciones sobre esas personas, acompañadas de interpretaciones. No son estimaciones de toda la población, resultados causales ni comparaciones controladas de herramientas de IA.